「AI に自社の文章を使われたくない」と言われて、robots.txt に User-agent: Google-Extended と Disallow: / を足す。ところが、検索結果に出る AI による概要(AI Overview)には自社のページが引用されたままのことがあります。
反映待ちでも、書き方の誤りでもありません。Google のクロール インフラストラクチャのドキュメントは、このトークンについてこう書いています。「Google-Extended が Google 検索でのサイトの登録に影響したり、Google 検索でのランキング シグナルとして使用されたりすることはありません」。効く相手が最初から違います。
この記事が扱うのは「止める側」だけです。AI 機能に出やすくする最適化は範囲に含みません。
Google-Extendedが管理しているのはGeminiの学習とグラウンディング
Google のクロール インフラストラクチャのドキュメントは、Google-Extended を「スタンドアロンのプロダクト トークンです」と定義しています。ウェブ パブリッシャーがこのトークンで管理する対象は、原文では次の 3 つです。
- 次世代の Gemini モデルのトレーニング(Gemini アプリと Gemini 向け Vertex AI API のベースになるもの)
- Gemini アプリでのグラウンディング
- Vertex AI での Google 検索を使用したグラウンディング
原文はグラウンディングを「事実確認と関連性向上を目的として、プロンプト入力時に Google の検索インデックスからモデルにコンテンツを提供すること」と説明しています。ここに検索インデックスという語が出るので混同しやすいところです。ただし Gemini アプリへの供給と Google 検索の AI による概要は、公式ドキュメントでも別の制御として案内されています。
専用のユーザー エージェント文字列は無い
サーバーのアクセスログで Google-Extended を探しても見つかりません。原文はこう書いています。
Google-Extended には、個別の HTTP リクエスト ユーザー エージェント文字列はありません。クロールは既存の Google ユーザー エージェント文字列を使用して行われます。robots.txt ユーザー エージェント トークンは制御機能で使用されます。
Google-Extended は取得しに来るボットの名前ではなく、robots.txt の中だけで意味を持つ制御用の名札です。CDN や WAF でユーザー エージェント名を条件にブロックしても、この名前では 1 件も当たりません。ログの照合でこの指定の効き目を測る方法は、この記事では扱いません。
検索の登録とランキングには効かない
同じブロックの最後に、検索への影響が名指しで否定されています。
Google-Extended が Google 検索でのサイトの登録に影響したり、Google 検索でのランキング シグナルとして使用されたりすることはありません。
この文が否定しているのは Google 検索への影響であって、Gemini アプリ側の扱いはこの一文の範囲外です。裏を返せば、このトークンを robots.txt で止めても、検索の掲載は 1 ページも減りません。
AIによる概要とAIモードは検索の側にある
Google 検索セントラルの「AI 機能とウェブサイト」は、サポートリンクとしてページが表示される条件をこう書いています。
AI による概要や AI モードでサポートリンクとしてページが表示されるには、ページがインデックスに登録されており、Google 検索でスニペットが表示され、検索の技術的要件を満たしている必要があります。これ以外に追加の技術要件はありません。
挙がっている条件はどれも通常の検索の条件で、AI 機能のための追加要件は無いと明記されています。この記述の対象は、サポートリンクとしてページが表示される条件です。
出る条件が検索と同じなら、絞る指定も検索の側にある
同じドキュメントは、制御の置き場所をこう書いています。
AI は検索に組み込まれており、検索が機能するうえで欠かせないものです。そのため、サイト所有者は Googlebot の robots.txt ディレクティブを使って、検索用にクロールされるサイトへのアクセスを管理します。検索に表示されるページからの情報を制限するには、
nosnippet、data-nosnippet、max-snippet、noindexコントロールを使用します。
robots.txt の Google-Extended ではなく、ページ側です(noindex などは robots meta タグ、data-nosnippet は HTML 要素の属性)。指定ごとの効き方と副作用は AIによる概要に自社ページを使わせない指定 で扱っています。
止めたい対象と、公式が置き場所として挙げている指定を並べます。
| 止めたい対象 | 指定 | 公式が挙げている操作 | 公式の記述 |
|---|---|---|---|
| Gemini のトレーニングとグラウンディング | Google-Extended |
robots.txt | 「Google がクロールする自社サイトのコンテンツを役立たせるかどうかを管理できます」 |
| 検索に表示されるページからの情報 | nosnippet / data-nosnippet / max-snippet / noindex |
検索に表示されるページからの情報を制限するコントロール | 「検索に表示されるページからの情報を制限するには、nosnippet、data-nosnippet、max-snippet、noindex コントロールを使用します」 |
| 検索用のクロール | Googlebot |
robots.txt | 「サイト所有者は Googlebot の robots.txt ディレクティブを使って、検索用にクロールされるサイトへのアクセスを管理します」 |
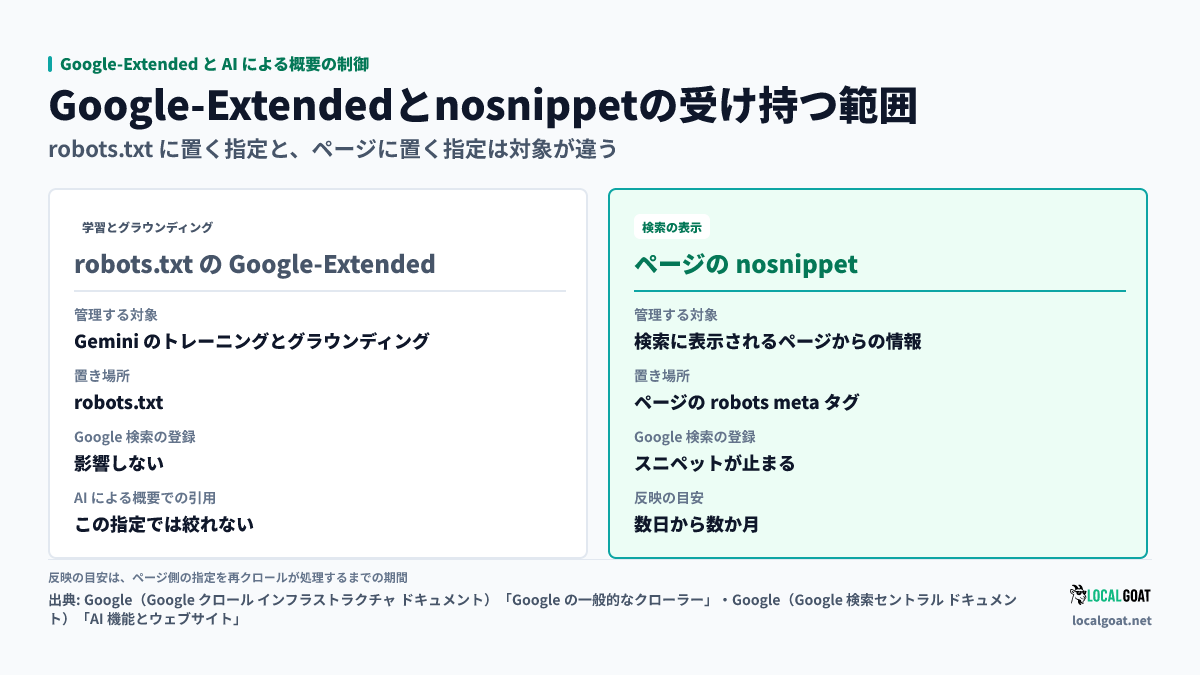
同じドキュメントは、この直後に「Google の他のシステムで AI トレーニングとグラウンディングを制限するには、Google-Extended の詳細をご確認ください。」と Google-Extended へ案内しています。公式のドキュメントの側も、AI 機能の制御と AI トレーニングの制御を別の対象として並べています。
反映までの時間と、効いたかどうかの確かめ方
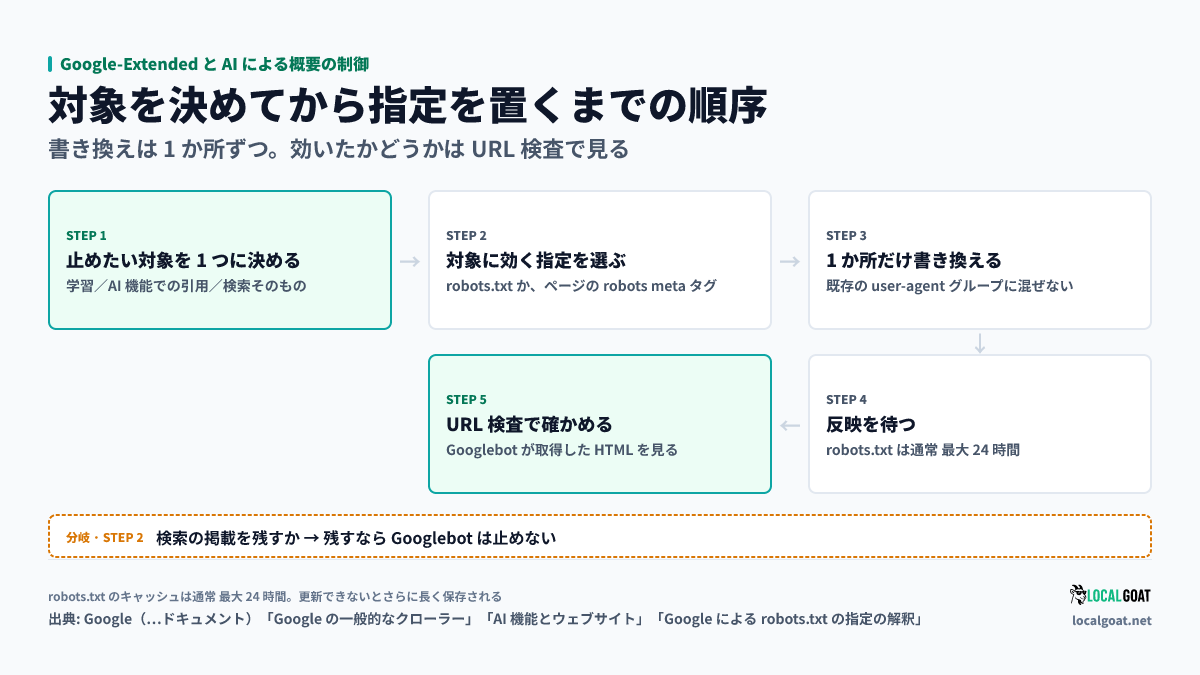
robots.txt 側とページ側では、効き始めるまでの時間が違います。robots.txt について、Google のドキュメントは「通常 robots.txt ファイルの内容を最大 24 時間キャッシュに保存します」と書いています。タイムアウトや 5xx エラーで内容を更新できないと、さらに長く保存する場合があるとも続きます。
ページ側の指定は、反映までもっと長くかかる場合があります。AI 機能のドキュメントは、再クロールについて「その頻度に応じて、クロールには数日から数か月かかる場合があります」と書いています。頻度を決めるのは Google 側で、サイト側は再クロールのリクエストを送れるだけです。
待つのか直すのかを分けるために、同じドキュメントは先に実装の確認を挙げています。
プレビュー コントロールに問題がなく、Googlebot が認識できるようになっていることを確認してください。正しく実装されているかどうかをテストするには、URL 検査ツールを使用して、ページのクロール中に Googlebot が取得した HTML を確認します。
そもそも AI による概要は、毎回出るものではありません。同じドキュメントは「AI による概要は、従来の検索結果に対して付加価値があるとシステムが判断した場合にのみ表示されるため、通常はトリガーされません。」と書いています。自社のページが概要に出なくなっても、それが指定の効果だとは限りません。
AI 経由の表示とクリックの推移そのものは、Search Consoleの生成AIパフォーマンスレポート の担当です。
robots.txtに1行足すときのつまずき
ここで扱うのは、既存の robots.txt にユーザー エージェントの行を足す場合だけです。設置場所や配信障害時の挙動は範囲外にします。
robots.txt の解釈のドキュメントは、適用されるグループの決まり方をこう書いています。
特定のクローラーに対して有効なグループは 1 つだけです。Google のクローラーは、robots.txt ファイルから自身のユーザー エージェントに一致する最も限定的なユーザー エージェントのグループを見つけることで、適切なルールグループを決定します。他のグループは無視されます。
グローバル グループとは結合されない
同じ節に、見落としやすい一文があります。「特定のユーザー エージェントのグループとグローバル グループ(*)は結合されません。」Google-Extended の行を独立したグループとして足した瞬間に、User-agent: * に書いてあった既存の Disallow は、このトークンには適用されなくなります。
さらに、複数のユーザー エージェントに適用するルールは user-agent 行を繰り返してグループ化できる、と原文は説明しています。ここを使って Googlebot の user-agent 行に Google-Extended の行を続けて 1 つのグループにまとめると、その Disallow: / は検索用のクロールにも当たります。
| robots.txt の書き方 | Google-Extended に適用されるグループ |
Googlebot に適用されるグループ |
|---|---|---|
User-agent: * のグループだけがある |
* のグループ |
* のグループ |
User-agent: * と User-agent: Google-Extended を別々のグループに分けた |
Google-Extended のグループだけ |
* のグループ |
User-agent: Googlebot と User-agent: Google-Extended を 1 つのグループにまとめた |
そのグループ | そのグループ(検索用のクロールも同じ Disallow に従う) |
グループの切れ目を決めるのは空行ではありません。原文は「allow、disallow、user-agent 以外のルールは、robots.txt パーサーによって無視されます。」と書いています。user-agent: a と user-agent: b の間に sitemap の行と空行が入った例についても、「1 つのグループとして扱われるため、user-agent a と b の両方が disallow: / ルールの影響を受けます」と説明しています。Google-Extended の行を足す位置を決めるときは、空行ではなく、直前に allow か disallow の行があるかどうかを見てください。
そもそも * に書いた行が全部のクライアントに届くとも限りません。Google のクローラーとフェッチャーの概要は「Google のクライアントには次の 3 つのタイプがあります。」と書いています。そのうち「一般的なクローラー」は「Google 製品で使用される一般的なクローラー(Googlebot など)。自動クロールでは常に robots.txt ルールに従います。」と説明されています。一方で「特殊なケース用のクローラー」には、「たとえば、AdsBot は広告パブリッシャーの許可に基づき、グローバル robots.txt ユーザー エージェント(*)を無視します。」という但し書きが付いています。
DigitalGOAT編集部の推奨は、書き換える前に次の 4 点を順に確かめることです。
- 現行の robots.txt を保存する
- 既存の
User-agentグループを一覧にし、足す行がどのグループに入るかを確認する(Google-Extendedの行をGooglebotのグループに足さない) Disallow: /の対象が、意図したユーザー エージェントだけかを確認する- 反映後に Search Console の URL 検査で、検索用のクロールが止まっていないかを確認する
なお、Google は robots.txt のファイルサイズの上限を 500 KiB としており、上限を超えた内容は無視されます。行を足し続けて肥大したファイルでは、足した行が読まれていない場合があります。
「AIに使われたくない」を1つに絞る
DigitalGOAT編集部の推奨は、指定を選ぶ前に次の 4 問で止めたい対象を 1 つに絞ることです。
- 困っているのは、学習に使われることか、AI の回答に引用されることか、検索結果から消えることか
- 引用されたときに困る理由は何か(誤引用/集客への影響/権利)
- 検索からの流入を失ってよいか
- 対象は全ページか、一部のページか
対象が決まったあとに置く指定は、DigitalGOAT編集部の推奨では次の順で決めます。
- 止めたい対象を 1 つに決める(学習/AI 機能での引用/検索そのもの)
- 学習だけなら、提供元が用意している学習用のトークンを robots.txt で止める(Google なら
Google-Extended。検索と AI による概要には効かない) - AI による概要・AI モードでの引用を絞るなら、対象ページに
nosnippetかmax-snippet:を置く - 検索からも消すなら
Googlebotを止める(検索用のクロールが止まる)
ただし、Googlebot を止める選択には但し書きがあります。robots.txt の解釈のドキュメントは「Google は、クロールが許可されていないページのコンテンツをインデックスに登録することはできませんが、URL をインデックスに登録して、スニペットなしで検索結果に表示することはできます。」と書き、インデックス登録をブロックする別の方法へ案内しています。クロールを止めても URL は検索結果に残りうるので、掲載そのものを消すのが目的なら robots.txt だけでは足りません。
Google 以外の提供元のトークンと、CDN 側での一括ブロックは、一次情報を別に確認する必要があるのでこの記事では扱いません。Google 以外の提供元が robots.txt の指定にどう従うかも、この記事が引いた 4 本のドキュメントの範囲では扱われていません。
止めたい対象を 1 つに決め、その対象に効く指定だけを置いたら、次は、実際に置いた指定が読まれているかを URL 検査で確かめ、robots.txt とページ側の両方を定期的に点検する段階に入ります。