「AIO対策」「LLMO対策」「GEO対策」「生成AI検索最適化」。ここ数年で呼び名が増えました。増えたのは呼び名で、やることがそれだけの数に分かれたわけではありません。
Google 検索セントラルの生成 AI 機能向け最適化のガイドは、この領域の用語をこう扱っています。
オンラインでは、回答エンジン最適化(AEO)や生成エンジン最適化(GEO)などの用語がよく使われますが、提案されている「ハック」の多くは効果がなく、Google 検索の実際の仕組みによってもサポートされていません。
否定されているのは「多く」であって全部ではありません。効くものと効かないものを分ける作業が残ります。この記事は、公式ドキュメントが条件として挙げたものと、「する必要はない」と名指ししたものを分けて並べます。以後は「AIO対策」で通します。
AIO対策・LLMO・GEOは同じ取り組みの別名
公式ガイドが訳語ごと挙げているのは、回答エンジン最適化(AEO)と生成エンジン最適化(GEO)です。AIO と LLMO は、ここで使った Google の一次情報の範囲では定義が見当たりません。それでも指している対象は同じで、生成 AI が組み立てた回答の中に自社のページを出すことです。
公式ドキュメントに出てくる呼び名はAEOとGEOだけ
ここに挙げた呼び名のうち、Google の公式ドキュメントに登場するのは AEO と GEO だけです。しかも公式は、この 2 語を「よく使われる用語」として紹介したうえで、そこにぶら下がる施策を否定する文脈で出しています。
| 呼び名 | 一般に使われている綴り | Google 公式ドキュメントでの扱い | この記事での呼び方 |
|---|---|---|---|
| AIO対策 | AI Overviews | 定義は見当たらない | AIO対策 |
| LLMO・LLMO対策 | Large Language Model Optimization | 定義は見当たらない | AIO対策 |
| GEO・GEO対策 | 生成エンジン最適化 | 「よく使われますが」の文で登場 | AIO対策 |
| AEO | 回答エンジン最適化 | 「よく使われますが」の文で登場 | AIO対策 |
| 生成AI検索最適化 | — | 「生成 AI 機能向けにウェブサイトを最適化する」の形で登場 | AIO対策 |
この記事が扱う範囲と、扱わない範囲
扱うのはサイト側の作業だけです。検索する側の設定、たとえばウェブフィルタの利用や Labs でのオプトアウトは対象外です。店舗や拠点の情報がどう扱われるかはローカルビジネス向けの解説へ、AI エージェントへの対応は本記事の範囲外として送ります。逆に「AI に使われたくない」という相談を受けたときの聞き取りは、DigitalGOAT編集部の推奨では四問に絞ります。困っているのが学習に使われることか、AI の回答に引用されることか、検索結果から消えることか。引用されて困る理由は何か。検索からの流入を失ってよいか。対象は全ページか一部か。止める側の手順は本記事では扱いません。
AIO対策が相手にしているAI機能はどれか
作業の話に入る前に、対象を固定します。この記事が扱うのは Google 検索の生成 AI 機能、つまり AI による概要と AI モードです。
出るかどうかを決めているのはGoogle側
Google 検索ヘルプは、AI による概要が出る場面をこう書いています。
Google 検索の検索結果に AI による概要が表示されるのは、生成 AI が特に有用であるとシステムが判断した場合です。たとえば、さまざまな情報源からの情報を迅速に提供できる場合などです。
判断しているのは Google のシステムです。特定のクエリで出す、出さないをサイト側から指定する経路は、この出典の範囲では書かれていません。サイト側が動かせるのは、出たときに引用される候補に入るかどうかです。
ヘルプは AI による概要を「ナレッジパネルと同様に、Google 検索の主要な機能です」と位置づけ、機能を無効にすることはできないと書いています。検索した側は、検索後にウェブフィルタを選べます。原文は「このフィルタを適用すると、AI による概要などの機能がないテキストベースのリンクのみが表示されます」としています。これは検索する側の操作で、サイト側の設定ではありません。
AI モードについては、AI による概要から AI モードでの会話にそのまま移れるようになったと書かれています。原文は「この機能は、AI による概要と AI モードがサポートされているすべての地域と言語のモバイル デバイスでご利用いただけます」としています。
日本語も提供範囲に入っている
ヘルプの「AI による概要の提供状況」は、提供している国・地域と言語を一覧で挙げています。その言語一覧に日本語が入っています。AIO対策をまだ海外の話として扱う前提は、この一覧の時点で成り立ちません。
Google公式が生成AI機能での表示条件として挙げているもの
条件は土台と方針に分かれます。土台は検索の技術要件で、その上に「何が評価されるか」の方針が載ります。
土台は検索の技術要件3つ
公式ガイドは、生成 AI 機能でページが表示されるための条件をこう書いています。
Google 検索の生成 AI 機能でページが表示されるには、ページがインデックスに登録されており、Google 検索でスニペットが表示され、検索の技術的要件を満たしている必要があります。
同じ箇所は、これに加えて Search Console の検索の生成 AI 機能にサイトが含まれている必要があるとも書いています。条件はこの二段構えです。
その「検索の技術的要件」を定めた技術要件のドキュメントは、最低限の要件として次の 3 つを挙げます。
- Googlebot がブロックされていないこと
- ページが機能していること(Google に HTTP
200 (success)ステータス コードが返される) - インデックス登録可能なコンテンツがページに含まれていること
原文の言い回しは「以下に示す最低限の技術要件を満たしているページは、Google 検索によるインデックス登録の対象となります」です。対象になるとしか書かれていないので、満たせば登録されると読み替えないでください。
公式ブログも同じ 3 点を挙げ、「技術要件を満たすことで、通常の検索結果に加え、AI 表示形式の結果にも反映されます」と続けています。AI 機能のための追加の技術要件は、ここで使った出典の範囲では出てきません。
3つの要件が実際に落ちる場所
要件の文面は短いのですが、落ちる場所は決まっています。
最初はクロールです。原文は「Google は、一般公開されているウェブページのうち、Google のクローラ(Googlebot)がクロールできるページのみをインデックスに登録します」と書き、続けて「ページが非公開にされている場合(アクセスにログインが必要など)、Googlebot はクロールしません」としています。会員限定の領域やステージング環境の残骸がここに当たります。原文は続けて「同様に、Google のインデックス登録をブロックする特定のメカニズムを使用しているページもインデックスに登録されません」とも書いています。robots.txt を開けても、ページ側に noindex が残っていれば要件は満たしません。
次はステータス コードです。原文は「Google は、HTTP 200 (success) ステータス コードが返ってくるページのみをインデックスに登録します」と書いています。エラーページを返す設定が残っていると、ページは見えていても要件から外れます。
最後はコンテンツの中身です。原文はインデックス登録可能なコンテンツの条件として「テキスト コンテンツが Google 検索でサポートされているファイル形式である」ことと「コンテンツがスパムに関するポリシーに違反していない」ことを挙げています。
JavaScript でページを組んでいる場合は、もう一段あります。公式ガイドは「ブロックされていない限り、Google は JavaScript 内のコンテンツを処理できます。ただし、JavaScript フレームワークを使用するウェブサイトで SEO を行うのは、一般的に他の種類のウェブサイトで行うよりも複雑です」と書いています。素の HTML ではなく、レンダリング後の結果で確認します。
技術要件の上に載る公式の方針
2025 年 5 月に公開された Google 検索セントラルのブログ記事は、AI 検索エクスペリエンスで成果を上げるための指針を見出し単位で並べています。通常の SEO と比べて何が変わるかの列を足すと、変わる箇所は限られます。
| 公式ブログの見出し | 中身 | 通常の SEO との差 |
|---|---|---|
| ユーザーに向けた価値の高い独自のコンテンツを重視する | 有益で満足度が高く独自性のあるコンテンツ | 差は無い |
| 優れたページ エクスペリエンスを提供する | 表示・操作・レイテンシ | 差は無い |
| Google がコンテンツにアクセスできるようにする | 上の技術要件 | 差は無い |
| プレビュー コントロールで公開設定を管理する | nosnippet・data-nosnippet・max-snippet・noindex | 効く範囲が AI 表示形式にも及ぶ |
| 表示されるコンテンツと構造化データを一致させる | マークアップの内容がページにも出ていること | 差は無い |
| テキスト以外も活用してマルチモーダルな成功を目指す | 高品質な画像と動画の追加 | 画像と動画の比重が上がる |
| アクセスの価値を理解する | クリック数以外の指標も見る | 測り方が変わる |
同じブログの冒頭は「Google がこれまでおすすめしてきた基本的な指針は、新しいエクスペリエンスにも当てはまります」と述べています。公式ガイドの側も、生成 AI 機能はコアとなる検索ランキングと品質システムに根差しているため SEO のベスト プラクティスは引き続き有効だ、と書いています。
表の中で内容に関わるのは最初の行です。公式ブログは同じ節で、AI 検索エクスペリエンスではユーザーがより複雑で具体的な質問や、さらなる理解を求めて追加質問を重ねる傾向があると書いています。原文は「こうしたニーズに応えるコンテンツを制作することが、成功へとつながる道です」と続けます。ページを増やす話ではなく、一つのページが答える問いの細かさを上げる話です。同じガイドは、ユーザーが検索しそうなバリエーションごとにページを作ることについて「Google 検索のランキングや生成 AI の回答を操作することを主な目的としてそのようなコンテンツを作成することは、Google の大量生成されたコンテンツの不正使用に関するスパムポリシーに違反します」と書き、「また、長期的な戦略としても効果的ではありません」と続けています。違反になるのは操作を主な目的としたときで、正当な目的で作るページ全部が対象ではありません。
新しい作業として残るのは、プレビュー コントロールの効く範囲と、画像・動画、そして測り方です。
公式が「する必要はない」と名指しした5項目
公式ガイドは「Google 検索では、次の要素は無視されます」と前置きして、次の 5 項目を挙げています。読者の判断が最も変わるのはこの節です。
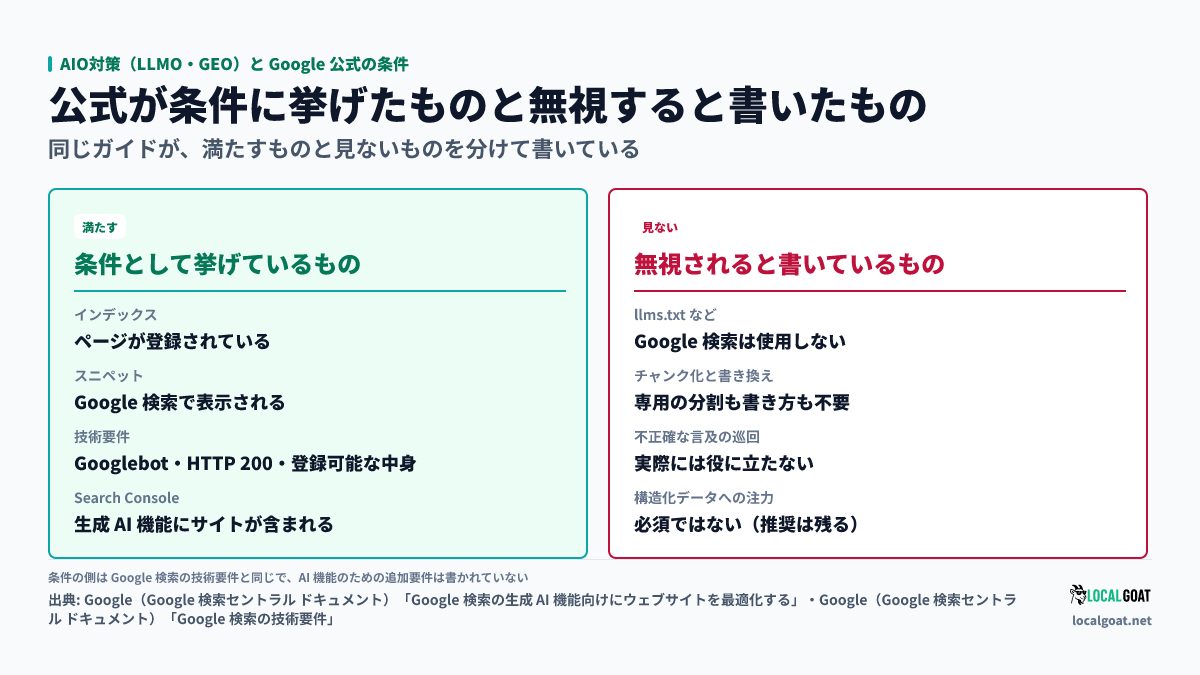
| 無視されると書かれた項目 | 公式が挙げる理由 |
|---|---|
| llms.txt などの「特別な」ファイル・マークアップ | Google 検索自体がそれらを使用しないため |
| コンテンツの「チャンク化」 | ページ上の複数のトピックのニュアンスを理解できるため |
| AI システム向けのコンテンツの書き換え | 類義語や一般的な意味を理解できるため |
| 不正確な「言及」の検索 | コアランキング システムが高品質のコンテンツに重点を置くため |
| 構造化データに過度に注力する | 生成 AI 検索に構造化データは必須ではないため |
表の中で但し書きが続くのはチャンク化と構造化データです。チャンク化の項は「ただし、オーディエンスやトピックによっては、短いページ(または長いページ)が効果的な場合もあります。理想的なページ長というものはありません」と続きます。分割をやめることと、長さを考えないことは別です。
llms.txtはGoogle検索では使われない
原文はこう書いています。
Google 検索(生成 AI 機能を含む)で表示されるようにするために、新たにコンピュータが解読可能なファイルや AI テキスト ファイル、マークアップ、マークダウンを作成する必要はありません。Google 検索自体がそれらを使用しないためです。
この出典が否定しているのは Google 検索での扱いに限られます。同じ項は、Google が HTML 以外のさまざまな種類のファイルを検出・クロール・インデックス登録することがあると断ったうえで、「これはそのファイルが特別な方法で扱われることを意味するものではありません」と続けています。
llms.txt は Google が作った規格ではありません。提案元のページは「We propose adding a /llms.txt markdown file to websites to provide LLM-friendly content.」と書いており、想定している読み手はエージェントです。原文は「Agents are expected to view or search llms.txt to find the information they need, then follow the relevant links.」としています。用途として最も多いのはソフトウェアのドキュメントで、原文は「llms.txt files are used most heavily for software documentation, where coding agents follow them to find API references and tutorials.」と書いています。
原文が必須と書いている項目は、プロジェクトかサイトの名前を入れた H1 だけです(「An H1 with the name of the project or site. This is the only required section」)。原文は用途を開発者向けドキュメントに限っていません。事業者が自社の構成と方針を示す場合、個人サイトが経歴について答える場合、学校が講座情報を出す場合も同じ形が使えるとして、「The same structure works anywhere agents need a guided path into a site’s content」と書いています。同じページは、AI ラボ自身が自社の開発者向けドキュメントで llms.txt を公開している例として OpenAI・Anthropic・Gemini を挙げています。つまり、Google 検索が使わないことと、ファイル自体に用途が無いことは別です。置くかどうかは、エージェントに読ませたい相手がいるかで決めます。
構造化データだけは扱いが違う
5 項目のうち、構造化データだけは後段の扱いが違います。原文は生成 AI 検索に構造化データは必須ではなく、特別な schema.org のマークアップを追加する必要も無いと書いたあと、こう続けています。
ただし、Google 検索のリッチリザルトの対象となる助けとなるため、SEO 戦略全体の一部として引き続き使用することをおすすめします。
「必須ではない」と「やめてよい」は別の意味です。ここを読み違えると、リッチリザルトの機会まで一緒に手放します。
どこから着手するかを決める
公式ガイドは、Google 検索で成功するためにこのガイドに記載されているすべてを行う必要はない、と書いています。技術要件のドキュメントも冒頭で「検索結果にページが表示されても一切料金は発生しません」と断っています。順番を決める材料は技術要件の側にあります。
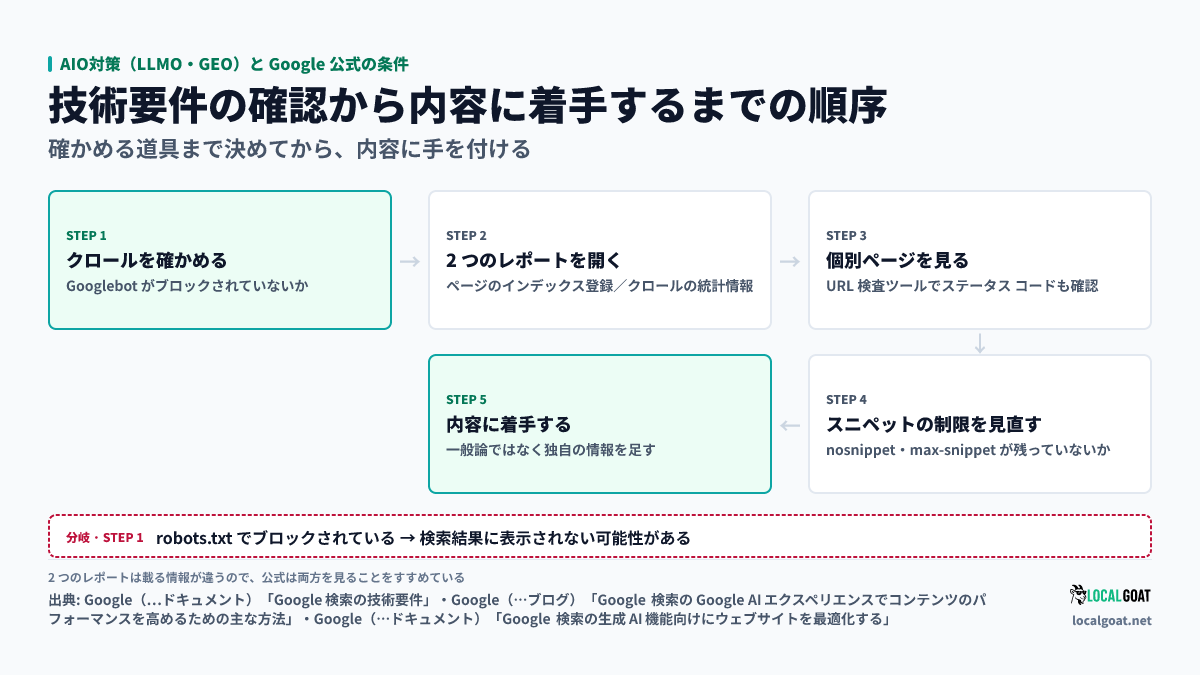
- Googlebot がブロックされていないかを見る。 技術要件のドキュメントは「robots.txt でブロックされているページは、Google 検索の検索結果に表示されない可能性があります」と書いています。Search Console のページのインデックス登録レポートとクロールの統計情報レポートを開きます。原文は「各レポートには URL に関する異なる情報が含まれている可能性があるため、両方のレポートを確認することをおすすめします」としています。片方だけでは足りないという指示です。ここで robots.txt に手を入れるなら、DigitalGOAT編集部の推奨する確認手順は、現行の robots.txt の保存/既存の
User-agentグループの一覧化(Google-Extendedの行をGooglebotのグループに足さない)/Disallow: /の対象が意図したユーザー エージェントだけかの確認/反映後の Search Console の URL 検査での検索用クロールの生存確認、の四項目です。 - 個別のページは URL 検査ツールで見る。 技術要件のドキュメントは「特定のページをテストするには、URL 検査ツールを使用します」と書いています。同じドキュメントは「特定のページの HTTP ステータス コードは、URL 検査ツールで確認できます」ともしています。
- スニペットの制限を見直す。 公式ブログは「制限を厳しくすると、AI エクスペリエンスでのコンテンツの表示が限定されます」と書いています。過去に入れた
nosnippetやmax-snippetが残っていないかを見ます。同じ確認で、インデックス登録をブロックするメカニズム(noindex)が残っていないかも見ます。指定ごとの効き方はスニペット制御の解説で扱います。 - ここまで済んでから内容に手を付ける。 公式ガイドは、コモディティ化されたコンテンツは読者に独自の洞察をほとんど提供しないと書いています。順番を逆にすると、読まれない場所に独自性を足す作業になります。
効いているかをどう測るか
公式ガイドは、測定先として Search Console の生成 AI パフォーマンス レポートを挙げています。レポート自体の見方は生成AIパフォーマンスレポートの解説で扱います。ここでは数の読み方の前提を挙げます。
まず、クリック数だけで判断しないことです。公式ブログは AI による概要が表示される検索結果ページからのクリックについて、より質が高いことが確認されていると書いたうえで、こう留保しています。
ただし、クリック数を優先しすぎると、本当に重要な検索からのアクセスの価値を十分に引き出せない可能性があります。
公式ブログは、見る指標についても書いています。原文は「販売や登録、関心の高いオーディエンス、ビジネスに関する情報検索など、サイト上のさまざまなコンバージョン指標も考慮しましょう」としています。AI 経由の流入をクリック数だけで評価すると、この行に並んでいる指標が抜け落ちます。
次に、母集団です。総務省の令和7年版 情報通信白書によると、日本で何らかの生成 AI サービスを使ったことがあると回答した割合は、2024年度調査で 26.7% でした。2023年度調査の 9.1% からは広がっていますが、測っているのは生成 AI サービスの利用経験であって、AI 検索経由の流入ではありません。白書はこの割合の出どころを「個人におけるAIの利用状況を把握するため、一般向けにアンケートによる調査を実施した」と書いています。年代別では差があり、白書は「20代において、2024年度調査では44.7%が利用したことがあると回答した」としています。
AI による概要そのものの正確さにも、公式の但し書きがあります。検索ヘルプは、生成 AI は不正確な情報や不適切な情報を提供することがあるとしたうえで、「つまり、AI による概要が常に正しいとは限りません」と書いています。同じヘルプは節の冒頭にも「AI の回答には間違いが含まれている場合があります」と置き、読者側の確かめ方として「重要な情報は必ず複数の情報源で確認してください」と書いています。誤った内容が出たときの訂正の手順は、本記事では扱いません。
まとめ:呼び名ではなく条件から着手先を決める
呼び名は複数ありますが、公式が条件として挙げたものは、Search Console の生成 AI 機能にサイトが含まれていることを除けば通常の検索の条件と同じで、AI 機能のための追加の技術要件は出てきませんでした。分かれるのは「する必要はない」と名指しされた 5 項目のほうで、これを続けるかやめるかが、AIO対策という語で売られている作業の実体です。
次に見るのは自社サイトの技術要件、つまり Googlebot がブロックされていないか、ページが正常に動作しているか、インデックス登録可能なコンテンツがあるかです。この確認が済むまでは、呼び名の違いを調べる時間を使わなくて済みます。